开源 OCR 文字识别工具 gImageReader 3.4.3,基于 Tesseract,支持图片/PDF 识别中英文并导出文本,中文界面,Windows 版内置引擎。
gImageReader 是一款开源的 OCR 图文识别工具,当前版本 3.4.3(2025 年 8 月发布),采用 GPL-3.0 协议开源,GitHub 上大约 2000 颗星。它用 C++ 和 Qt6 开发,本质是给开源 OCR 引擎 Tesseract 套了一层图形界面——把图片或者 PDF 丢进去,识别出来的文字可以直接编辑、复制、导出,省掉了敲命令行的麻烦。Windows 版安装包内置了 Tesseract 引擎,装完就能用,本文提供的是 Windows 64 位安装版。
打开后界面比较简单:左边是文件列表和图片预览,右边是识别出来的文本区域,顶部是一排工具按钮。左边面板可以「Add Images」添加图片,也能直接把图片拖进来,还支持导入 PDF 文件——一个多页 PDF 会被拆成多页逐页识别。工具栏上放大、缩小、旋转、自动识别版面这些常用操作都在。
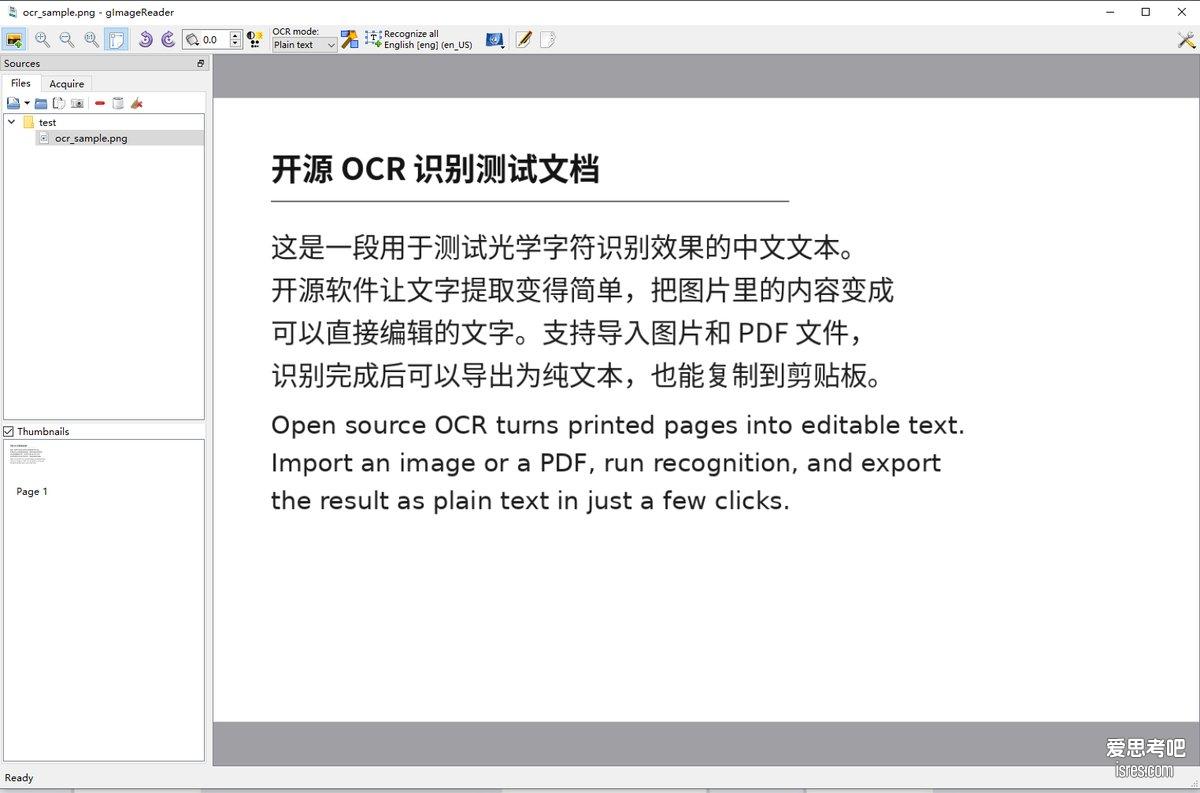
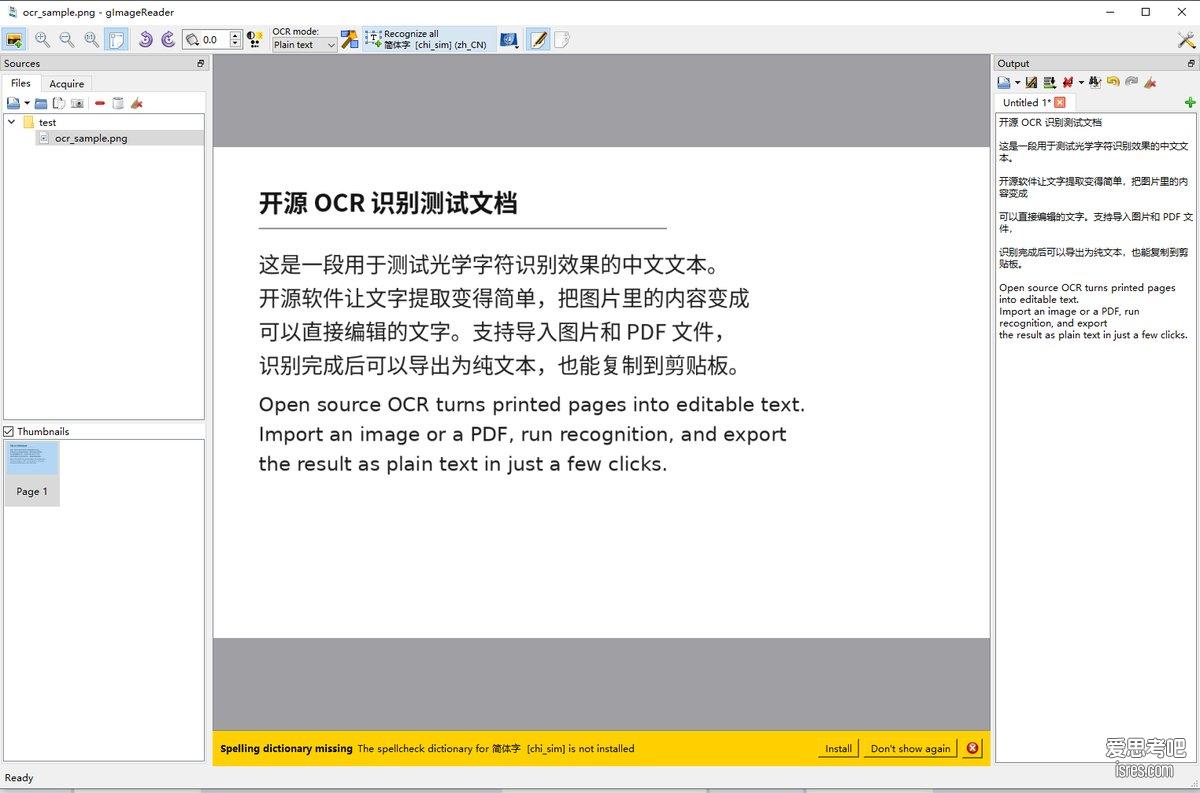
识别之前先确定用哪种语言。点工具栏「Recognize all」右边的小箭头,会弹出语言菜单,里面列出已经安装的语言包,勾选「简体字 [chi_sim]」就能识别中文,要中英文混排就再勾上 English;同时勾选多项时引擎会按多语言处理。像下图这种中英混排的文档,识别出来基本能对得上。
选好语言点「Recognize all」,等一会儿右边文本区就会出现识别结果。识别完成后可以导出成纯文本、HOCR 或者 PDF,也能直接复制到剪贴板。识别精度取决于原图的清晰度,扫描件、截图这类规整的印刷体效果都不错,手写体就别抱太大期望。
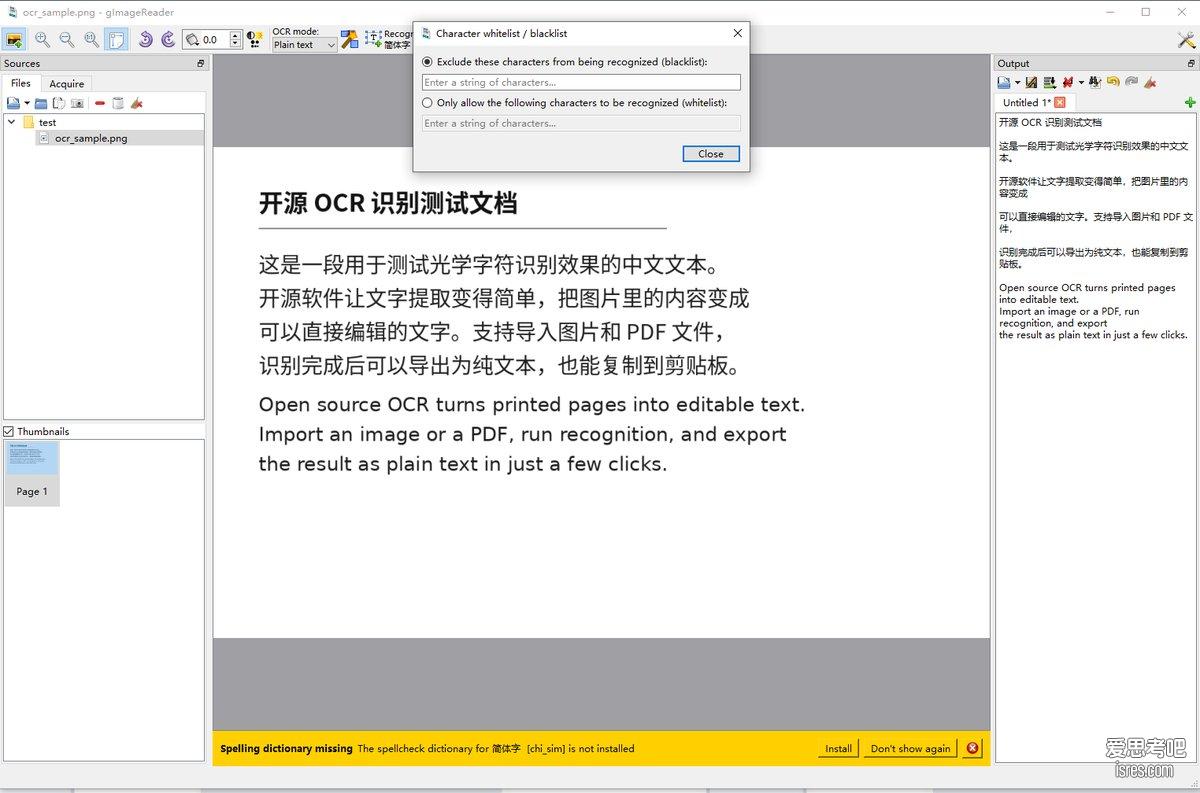
如果对识别效果有要求,菜单里还留了几个可调项:「Page segmentation mode」页面分割模式,可以指定单行、单块、稀疏文字等不同版式;「Character whitelist / blacklist」字符白名单/黑名单,能限定只识别或者排除某些字符,比如只要数字就设成白名单。识别表格、数字或者特殊排版时会用到。
使用上没什么门槛,安装包内置引擎,装完直接打开就能用。有几点提前说明:识别中文需要简体中文语言包,本文提供的安装包里已经放好了;它是纯本地软件,不需要联网,图片也不会上传,识别全程在你自己电脑上完成;Tesseract 的强项是印刷体,复杂排版和手写识别效果一般;另外它是跨平台软件,Windows、Linux、macOS 都有对应版本,本文提供的是 Windows 64 位版。
下载地址(夸克网盘):https://pan.quark.cn/s/bcb23ef49869 提取码:ggkm
请优先阅读正文中的使用说明与相关许可信息。
本文《开源OCR文字识别工具gImageReader 3.4.3下载,图片和PDF都能转成可编辑文字》由爱思考吧 isres.com 分享,转载请注明出处。本文网址:https://www.isres.com/bangong/gimagereader.html
本站主要收集测评能够节省时间和提升效率的软件工具并分享使用与学习的过程和感受,任何情况下用户都需遵守所使用软件资源的相关协议。与《开源OCR文字识别工具gImageReader 3.4.3下载,图片和PDF都能转成可编辑文字》有关的本站文章及资源仅供个人学习交流使用,相关资源请下载后24小时内删除,请勿用于其它用途,因此产生的任何问题由您自行承担。